O usuário descobre antes da TI
A primeira notificação é um chamado. Ou seja, o impacto já começou e o relógio já está correndo contra você.

 JD Edwards EnterpriseOne
O NovaCon AlwaysOn monitora continuamente seu ecossistema JD Edwards, identifica sinais de degradação, abre um ticket numerado por incidente e transforma dados operacionais em contexto para a sua equipe agir, antes que um job travado vire indisponibilidade.
Agentless por design: nada é instalado nos seus servidores JD Edwards.
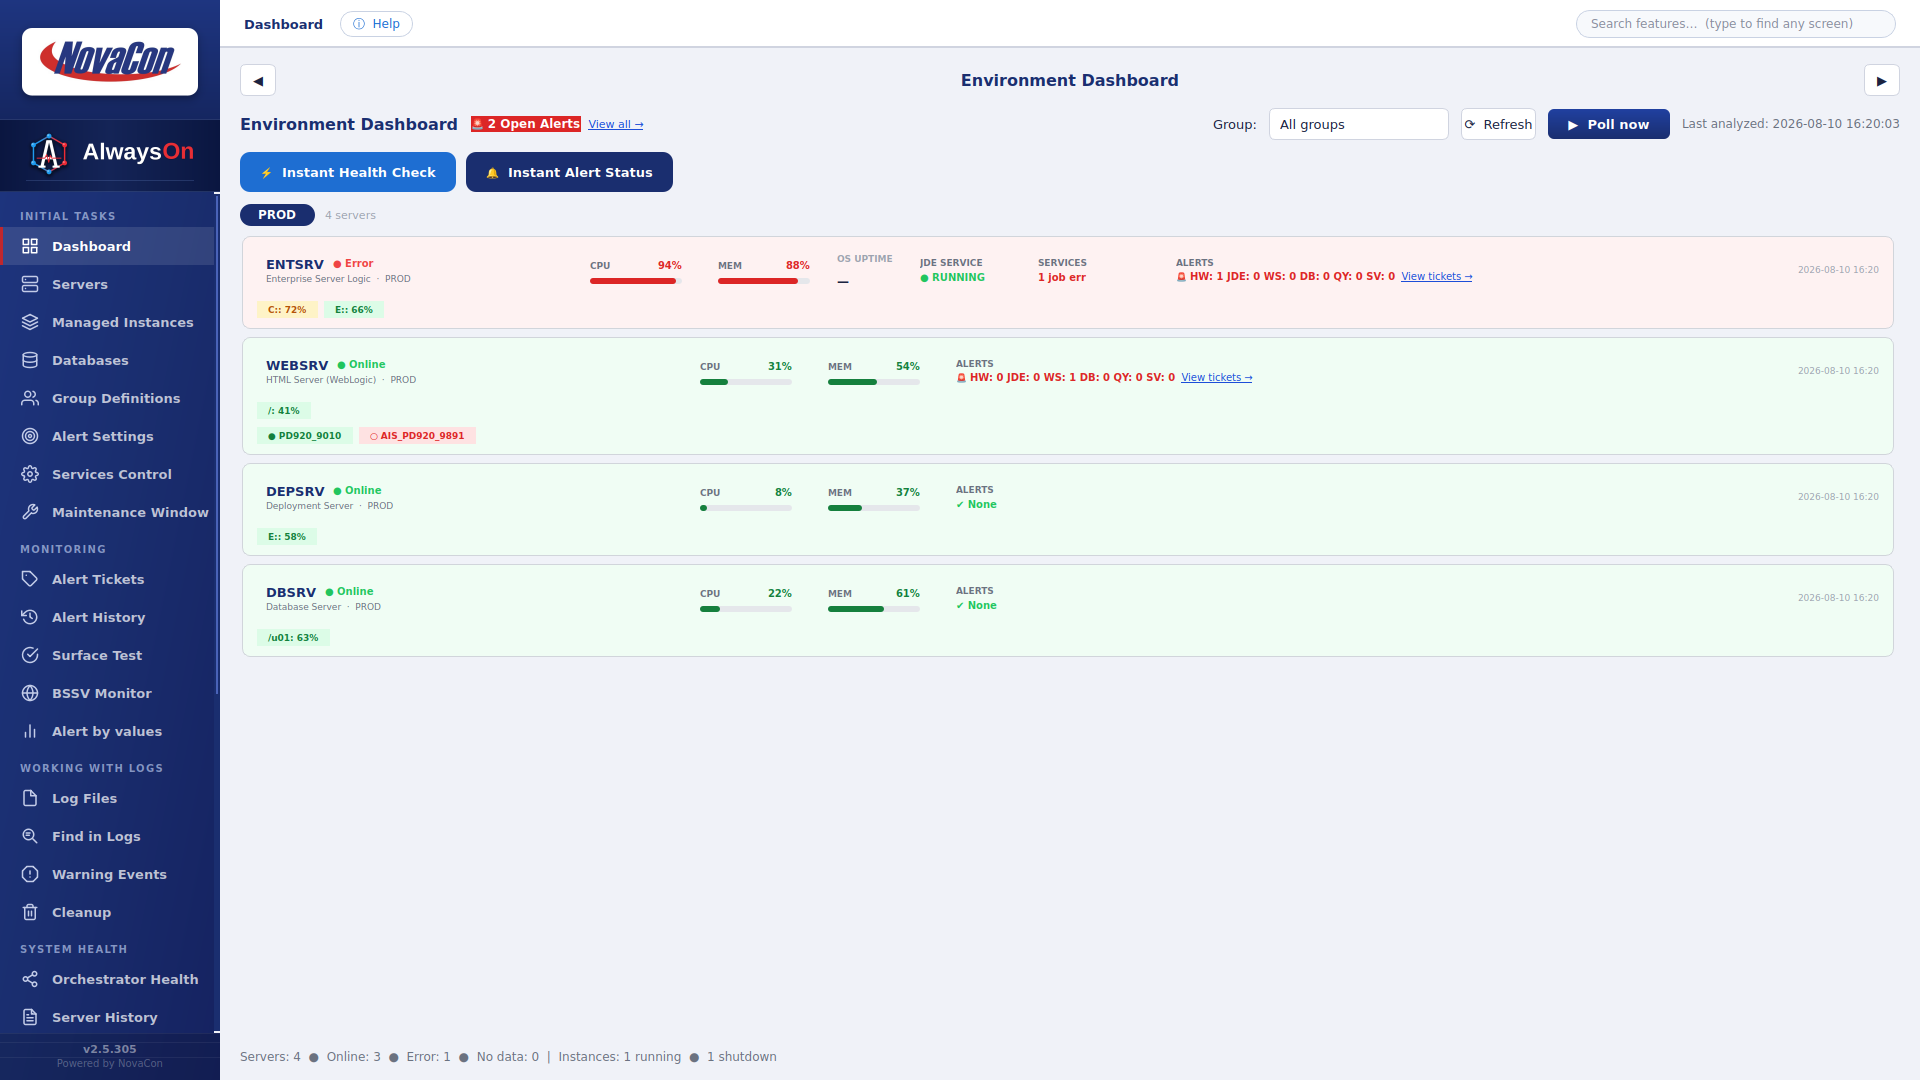 ENTSRV · CPU 94% acima do threshold
Serviço JDE RUNNING
Antes que um problema vire indisponibilidade, quase sempre existem sintomas: um job que não conclui, um processo que cresce, um serviço que degrada, um blocker no banco, um disco que se aproxima do limite ou uma instância que deixa de responder como deveria. A questão é se alguém enxerga isso a tempo.
A primeira notificação é um chamado. Ou seja, o impacto já começou e o relógio já está correndo contra você.
Oracle, Enterprise Server, WebLogic, AIS, filas de batch e logs acabam sendo investigados em consoles diferentes, por pessoas diferentes.
O diagnóstico depende dos poucos especialistas que sabem exatamente onde procurar, e esse conhecimento raramente sobrevive a umas férias ou a um desligamento.
O problema é resolvido, mas sem histórico registrado o padrão por trás dele continua invisível. E ele volta.
Fora do horário comercial, encontrar causa e contexto pode exigir acesso a vários ambientes e consoles antes mesmo de o trabalho real começar.
Saber que a CPU está alta ou que uma porta está aberta não é o mesmo que entender o efeito disso sobre os kernels jdenet, uma fila de UBE ou uma instância AIS.
O objetivo não é produzir mais alarmes. É diminuir o tempo entre “algo está errado” e “sabemos onde olhar e o que fazer”.
Coletores agentless se conectam por SSH, WMI/WinRM, REST e conexões de banco, de forma contínua e em todas as camadas.
51 tipos de alerta avaliados contra thresholds definidos por grupo e categoria, com regras de duração sustentada que ignoram picos.
Um ticket numerado por incidente, reaproveitado até a resolução, com o valor medido, o threshold e todo o histórico de avaliação por trás.
Ações operacionais protegidas: limpeza, controle de serviços e comandos agendados, com start, stop e restart sempre aguardando aprovação humana.
O AlwaysOn monitora continuamente componentes de infraestrutura, serviços JD Edwards, middleware e bancos de dados, centralizando status, alertas, histórico e ações operacionais em uma única experiência, em cerca de 45 telas organizadas do jeito que o trabalho realmente acontece.
Visibilidade contínua sobre hosts, serviços JD Edwards, instâncias gerenciadas WebLogic e bancos de dados: Linux por SSH, Windows por WMI e WinRM, IBM i através de DB2 for i SQL Services.
Alertas contextualizados com tickets numerados automaticamente, thresholds por grupo, regras de duração sustentada, cooldowns, snooze, janelas de manutenção, histórico completo e resolução automática.
Limpeza protegida de logs e runtime cache, comandos de SO agendados, controle de serviços e resolução de locks de banco em um clique. Trabalho repetitivo feito com segurança e sempre confirmado.
Um monitor genérico informa que o host responde. O AlwaysOn informa que o batch engine caiu, que faltam kernels jdenet, que o Scheduler parou de disparar ou que uma instância AIS está recusando conexões na 9891, no vocabulário que a sua equipe CNC já usa.
ORA-00600 encontrado no jde.logA família de tickets JDE cobre 10 tipos de alerta dedicados exclusivamente aos serviços do Enterprise Server.
“O Scheduler está realmente disparando?” é respondido em uma tela, não lendo log no Enterprise Server.
As queries de monitoramento são read-only por padrão. Qualquer ação de escrita é explícita, controlada e registrada.
Leitura feita pelas APIs REST do WebLogic e do Server Manager, sem nenhum agente implantado na camada web.
Só a família de hardware responde por 11 dos 51 tipos de alerta.
Alertar tudo não é monitorar melhor. É assim que uma equipe aprende a ignorar o próprio monitor. Todo alerta do AlwaysOn passa pelos mesmos sete passos antes de chegar a um humano.
Este tipo de alerta está habilitado para o grupo e a categoria daquele servidor? A configuração vive no grupo, nunca em cada servidor.
O valor medido é comparado com o threshold daquele grupo e categoria, entregue com defaults de fábrica sensatos.
Onde se aplica, a condição precisa se manter por N minutos contínuos. Uma única leitura falsa zera a sequência, então um pico nunca aciona ninguém.
Snooze, regras de pausa, janelas de deploy e janelas de manutenção interrompem o alerta antes que ele abra ticket ou dispare e-mail.
Depois do envio, o mesmo alerta fica em silêncio por um tempo definido. O ticket continua aberto: você não é avisado duas vezes do mesmo problema.
Uma chave de dedup identifica o incidente e reaproveita o número dele, então um problema mantém um histórico em vez de se espalhar pela caixa de entrada.
Quando a condição volta ao normal, o ticket é encerrado sozinho e um e-mail verde de RESOLVED é enviado.
O Alert History guarda cada avaliação: valor, threshold, resultado e o cooldown que segurou o disparo.
51 tipos de alerta em 9 famílias de ticket. O prefixo do ticket já diz, de imediato, de quem é o problema.
Todas as telas abaixo são do produto real, versão 2.5.305. Não são mockups.
Status, CPU, memória, disco por ponto de montagem, uptime do sistema operacional, estado dos serviços JDE e alertas abertos por família, para cada servidor do grupo, atualizado continuamente.
Todo alerta gerado pelo sistema abre um ticket numerado. O mesmo número é reaproveitado enquanto o problema continua aberto, então o incidente mantém uma única identidade do primeiro sinal até a resolução.
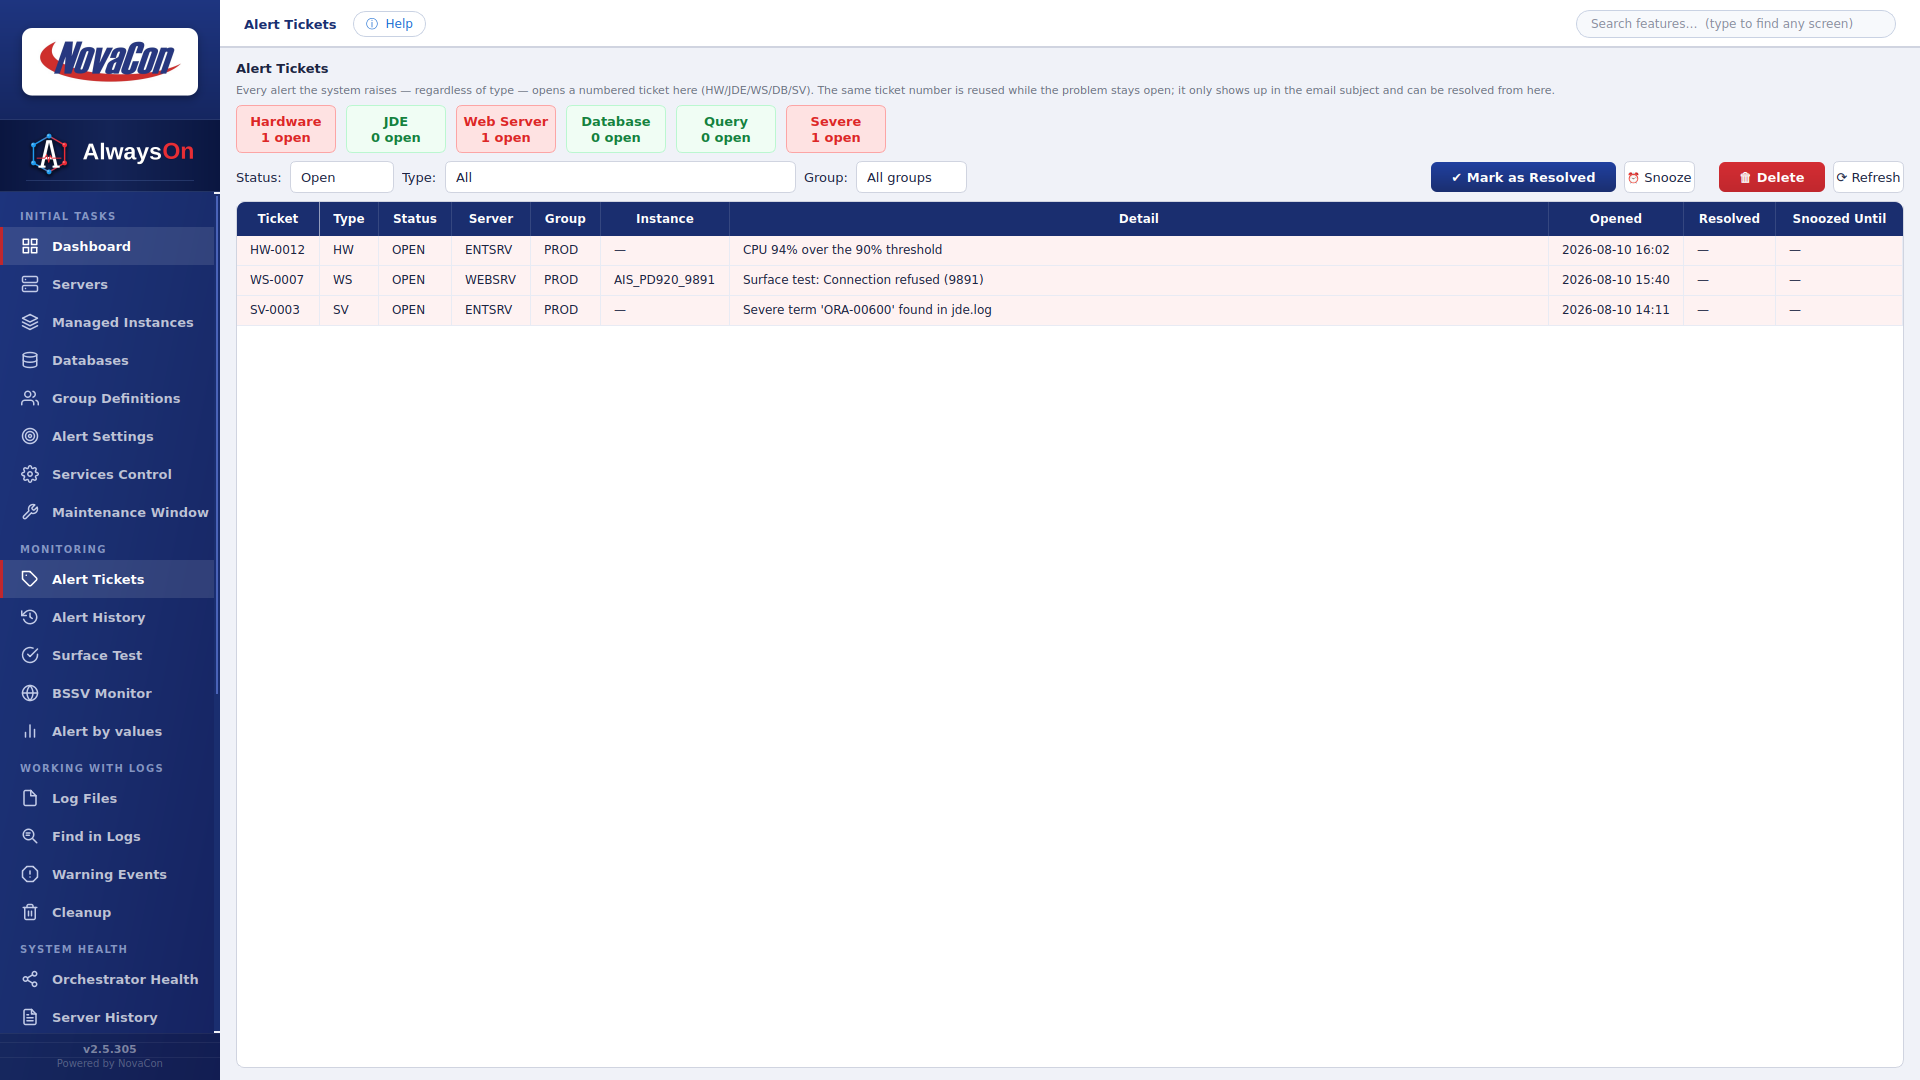
State, health, portas e usuários ativos de cada instância gerenciada, lidos pelas APIs REST do WebLogic e do Server Manager, sem nada instalado na camada web.
Testes de login JD Edwards agendados por instância gerenciada, para HTML, AIS e BSSV, medindo não só se o endpoint responde, mas quanto tempo o login leva.
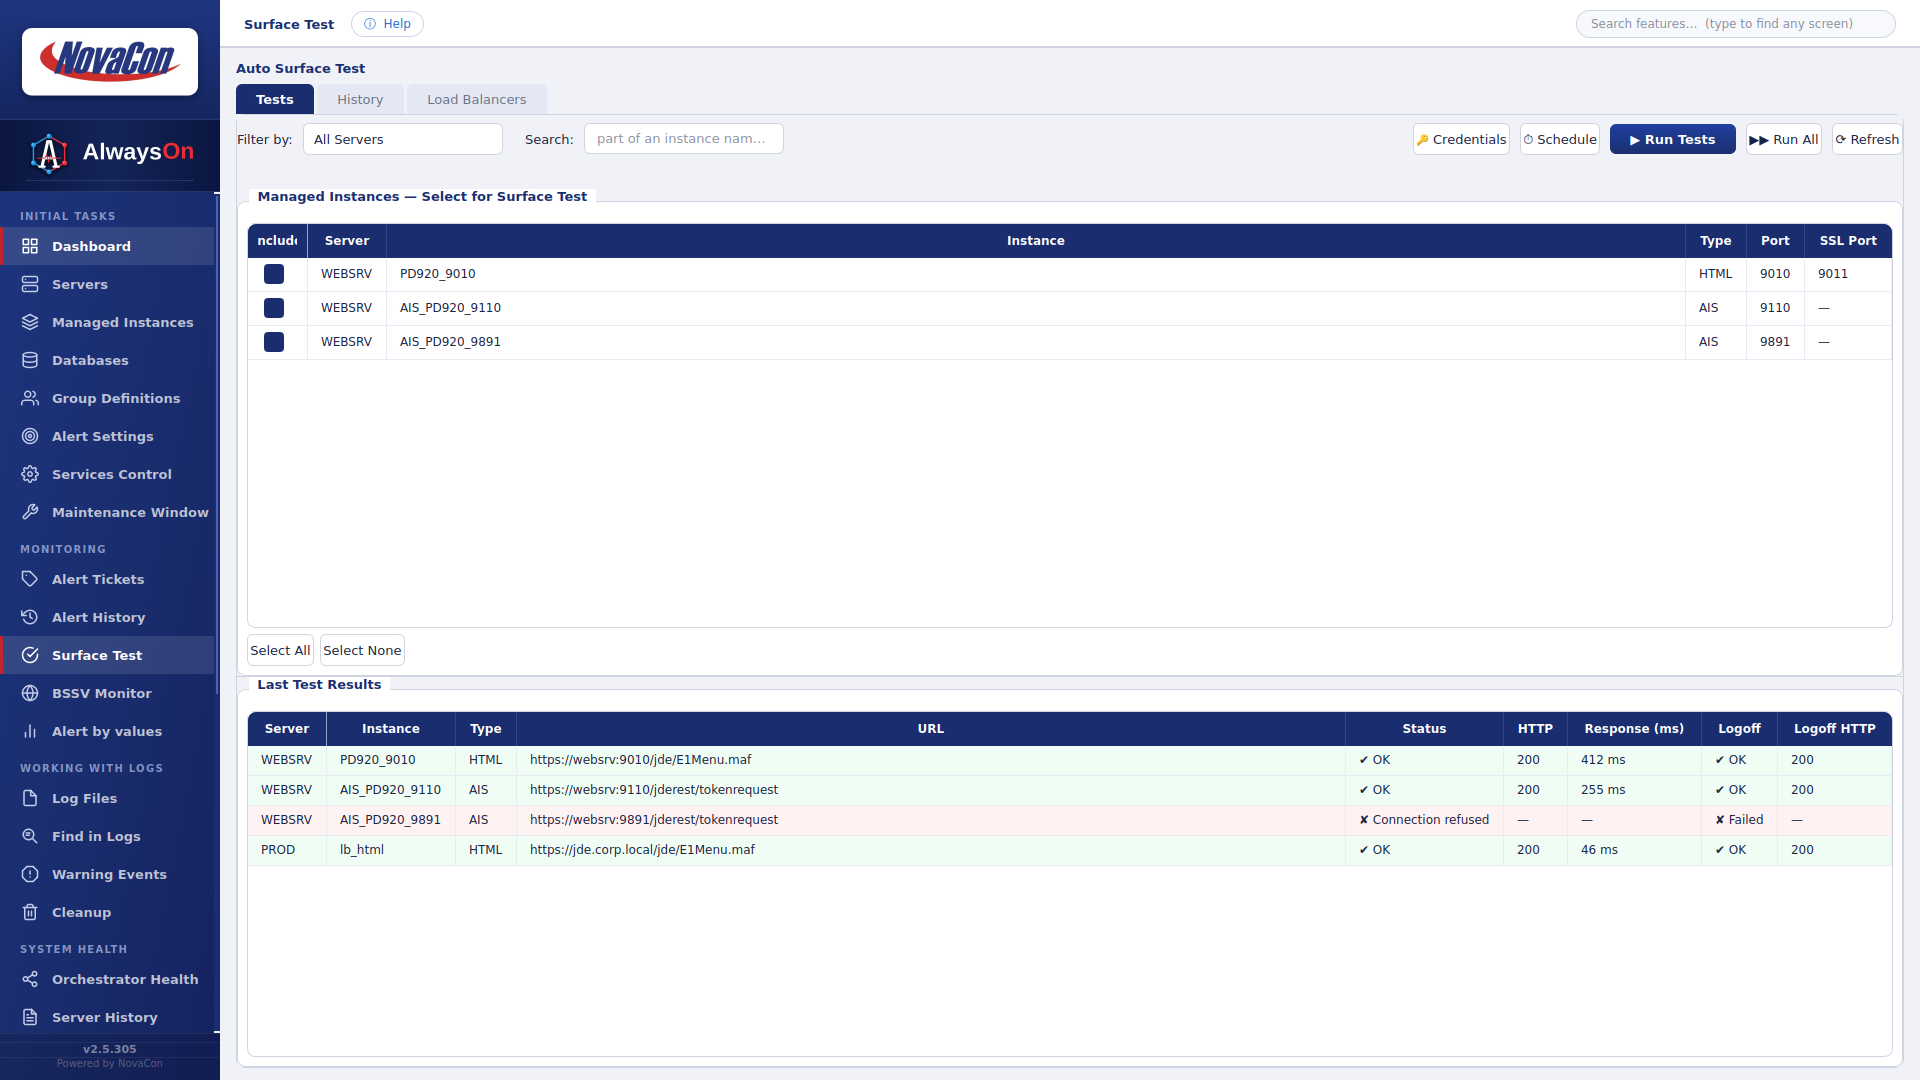
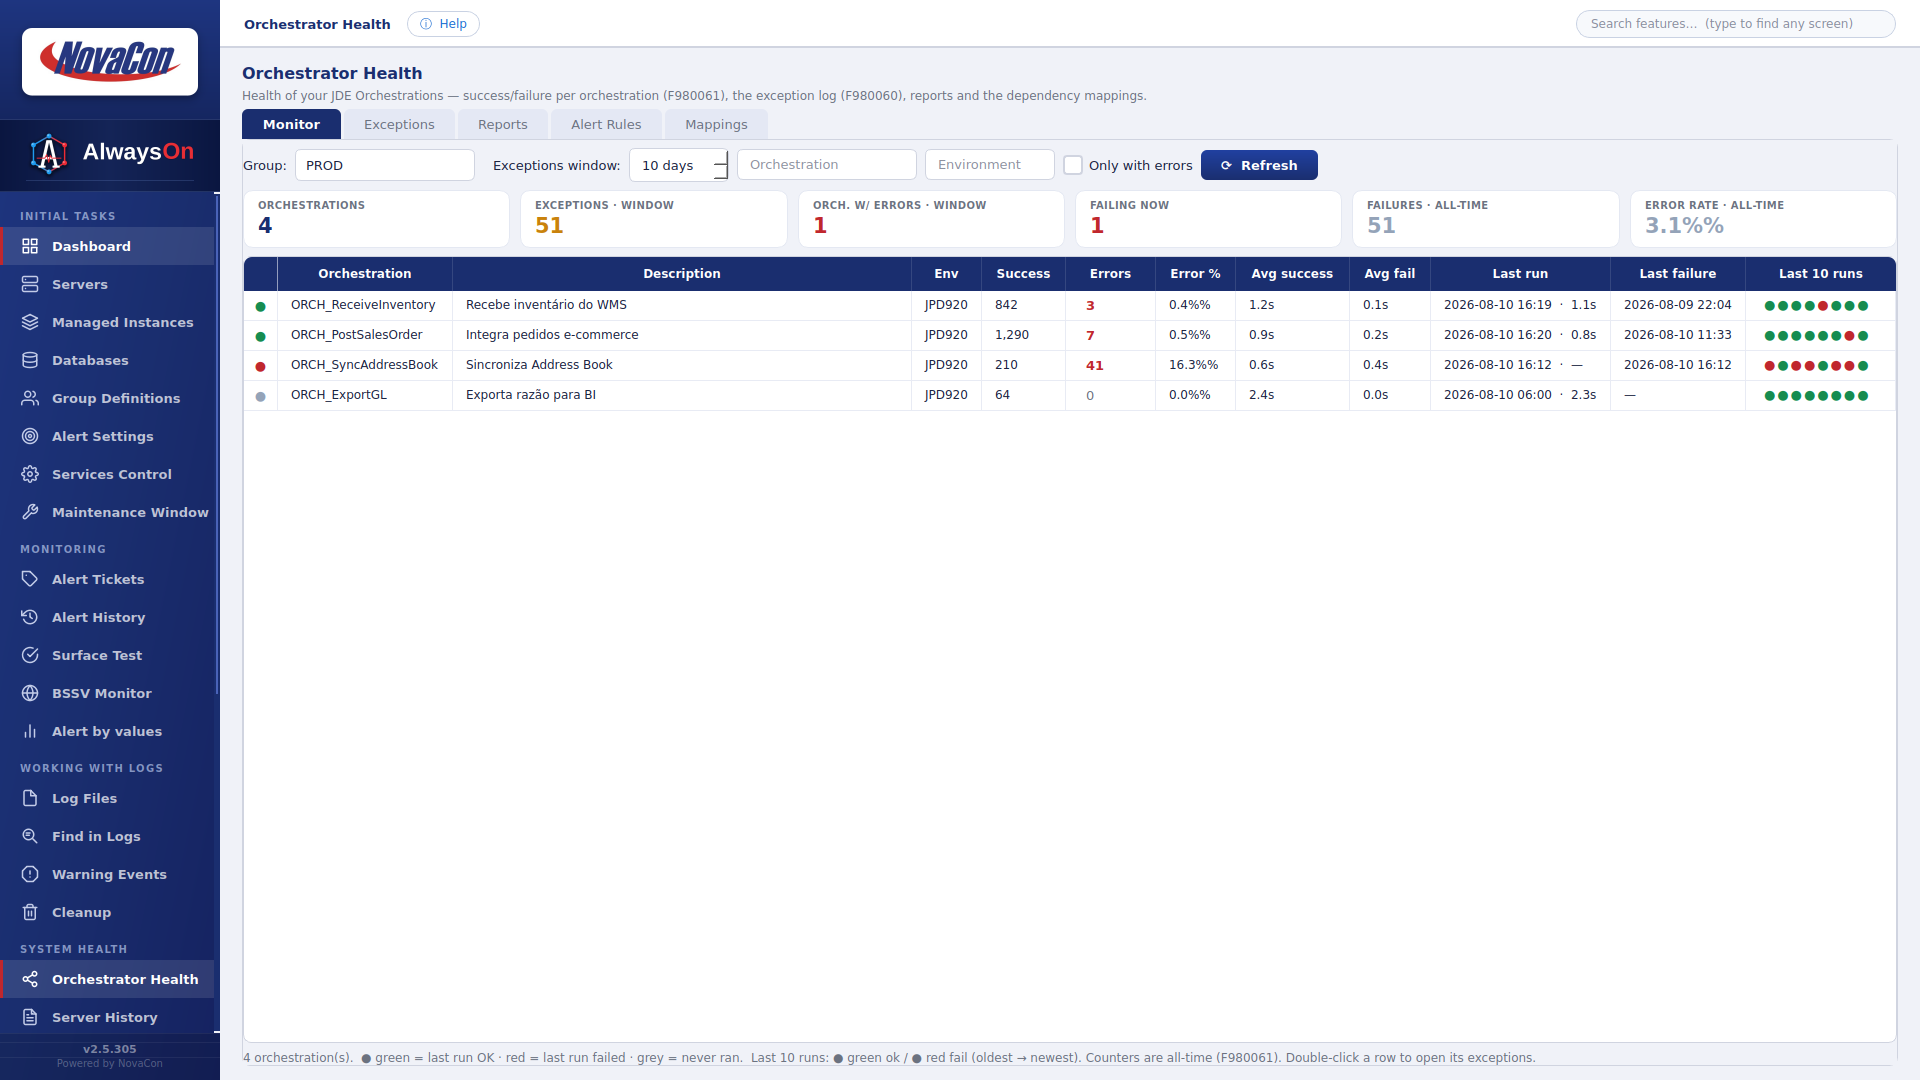
O Scheduler JDE está disparando? Quais orquestrações estão falhando e quanto tempo levam? As duas perguntas ganham uma tela em vez de uma investigação.
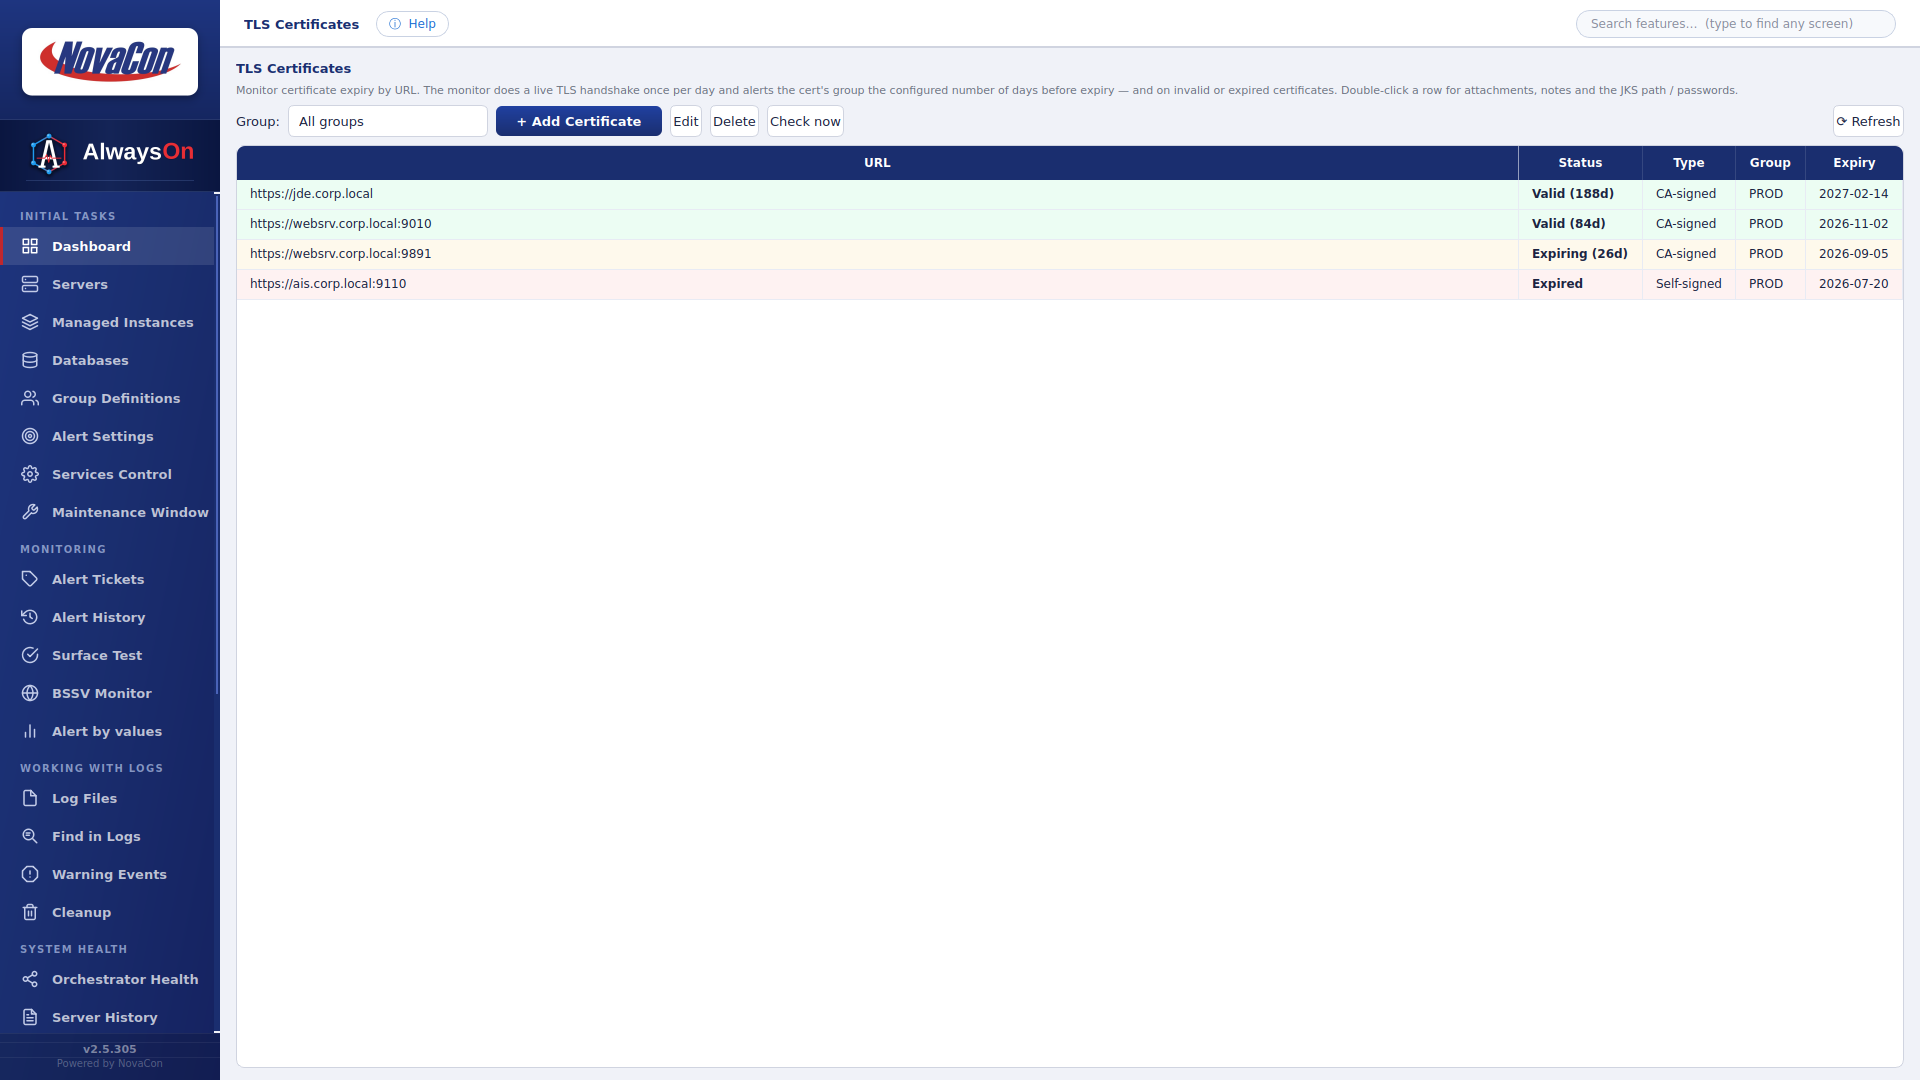
Cada endpoint monitorado é verificado diariamente e alerta bem antes do vencimento. É a classe de indisponibilidade que é totalmente evitável e mesmo assim acontece num domingo.
Automação não significa remover controle. As ações sensíveis continuam explícitas, limitadas e auditáveis, que é exatamente o motivo pelo qual se pode confiar nelas.
Limpeza de logs e de runtime cache por servidor, por grupo ou após reboot. O Find lista cada job de runtime cache com seu tamanho real, para você limpar seletivamente, com todo caminho validado e confirmação forte.
Comandos de sistema operacional por SSH ou PowerShell, agendados e executados de um único lugar, em vez de a partir de seis sessões de terminal.
Iniciar e parar instâncias gerenciadas e serviços do Enterprise Server, de forma protegida e confirmada antes de qualquer coisa acontecer.
Blockers em vermelho, waiters em amarelo. Resolva uma sessão específica, ou todos os blockers, em um clique, na mesma tela que mostrou o problema.
Se um auto-kill reporta sucesso e o processo continua vivo no ciclo seguinte, o produto informa isso em vez de confiar no próprio resultado.
A limpeza valida cada caminho antes de agir e é estruturalmente impedida de remover o produto. É a barreira que torna todo o resto seguro.
O AlwaysOn é deliberadamente construído em três níveis de autoridade. Você pode ficar no primeiro indefinidamente, e muitas equipes ficam. Os níveis acima dele só agem dentro dos limites que você definir.
Ver antes que alguém reporte.
Chegar ao diagnóstico mais rápido.
Automação com autoridade controlada.
Nenhum percentual aqui: esses números dependem do seu ambiente, não do nosso marketing. O que segue é a mudança na forma como o trabalho é efetivamente feito.
Uma ferramenta de monitoramento guarda credenciais de todas as camadas do seu ERP. Isso faz da forma como ela armazena, usa e registra essas credenciais uma restrição primária de projeto, não um item de checklist.
O banco local é um store SQLCipher (AES) criptografado, ilegível sem a chave.
Toda senha de sistema operacional, banco, serviço, administração e keystore é criptografada, nunca armazenada em texto claro.
As queries de monitoramento de banco são read-only por padrão. Ações de escrita são explícitas e controladas.
A limpeza valida cada caminho e exige confirmação forte, e nunca consegue apagar o próprio produto.
Uma trilha read-only de cada mudança de configuração e de cada escrita executada contra um banco registrado, com o comando e a origem. Acesso a credenciais e todo estado de alerta ficam registrados.
Senha de aplicação obrigatória com hash Argon2, 2FA TOTP opcional com proteção contra replay, login por OTP em e-mail com limitação de tentativas, e um token de máquina somado a uma sessão humana com tempo limitado protegendo cada requisição.
Chaves de host SSH e TLS são fixadas no primeiro uso, de modo que a personificação de um host monitorado é detectada em vez de aceita.
O backend do desktop escuta em 127.0.0.1. O acesso via navegador é um console HTTPS separado e opcional, em porta própria, desligado por padrão, com credenciais mascaradas no servidor antes de qualquer resposta sair da máquina.
Histórico de sign-on do JD Edwards a partir da F9312 e auditoria de usuário de banco por conexão, com regras que sinalizam (ou, em modo Final, desativam) usuários inativos há tempo demais, protegidas por lista de exceção e fusível percentual.
O AlwaysOn se conecta, lê e reporta. Nenhum agente é instalado nos seus servidores JD Edwards, e nada roda onde não deveria.
Arquitetura conforme documentada para o AlwaysOn v2.5.305.
O AlwaysOn nasce da prática diária de uma consultoria dedicada exclusivamente a operar, modernizar e proteger ambientes JD Edwards. Cada alerta dele existe porque alguém precisou dele às 3 da manhã.
Uma consultoria dedicada somente a JD Edwards CNC, sem conflitos de interesse e com profundidade em vez de amplitude.
Especialistas certificados trabalhando junto com a sua TI interna em todas as plataformas suportadas pelo JD Edwards, com mentalidade de parceria de longo prazo.
O AlwaysOn é um produto de monitoramento, alertas e automação criado especificamente para ambientes Oracle JD Edwards EnterpriseOne. Ele roda como um cliente desktop somado a um serviço Windows sempre ativo, coleta continuamente dados de infraestrutura, serviços JD Edwards, instâncias gerenciadas WebLogic e bancos de dados, e centraliza status, alertas, histórico e ações operacionais protegidas em cerca de 45 telas.
Ele foi desenhado para cobrir o que o monitoramento genérico de infraestrutura não alcança: a camada JD Edwards. Um monitor de propósito geral informa que a CPU está alta ou que uma porta está aberta. O AlwaysOn avalia kernels jdenet, o batch engine, filas de UBE, o Scheduler JDE, instâncias gerenciadas JAS/AIS/BSSV, blockers e tablespaces no Oracle e logins reais no JD Edwards, e também cobre CPU, memória, disco por ponto de montagem e acessibilidade no nível do host. Se ele substitui ou complementa a sua ferramenta atual depende do seu parque, que é exatamente o tipo de pergunta que um diagnóstico responde.
Serviços do Enterprise Server, com kernels jdenet, batch engine, portas JDE, security server, processos zombie e descontrolados; batch e UBE, com jobs em erro, jobs aguardando, o Scheduler JDE e o histórico do Job Monitor; a camada web, com instâncias gerenciadas WebLogic e WebSphere, JAS, AIS e BSSV, surface tests e web exceptions; bancos de dados Oracle, SQL Server e DB2 for i; o Orchestrator; certificados TLS; e os hosts subjacentes. No total, 51 tipos de alerta distribuídos em 9 famílias de ticket.
Não. O AlwaysOn é agentless por design. Ele se conecta de saída para coletar: SSH para hosts Linux, WMI e WinRM para Windows, as APIs REST do WebLogic e do Server Manager para a camada web, e conexões padrão de banco para Oracle e SQL Server. Enterprise servers em IBM i são lidos através de DB2 for i SQL Services. Nada é instalado nos seus servidores JD Edwards e nada fica para trás.
O AlwaysOn roda dentro da sua rede e alcança o seu parque JD Edwards por SSH, WMI/WinRM, REST e conexões de banco. Onde essas conexões forem permitidas, seja on-premises, em ambientes hospedados em nuvem ou numa combinação dos dois, os coletores funcionam da mesma forma. Caminhos de rede e regras de firewall fazem parte do que um diagnóstico mapeia para a sua topologia específica.
Por meio de sete passos sequenciais. O tipo de alerta precisa estar habilitado para o grupo e a categoria daquele servidor; o valor medido precisa cruzar um threshold definido por grupo; onde se aplica, a condição precisa se manter por N minutos contínuos, então uma única leitura falsa zera a sequência; snooze, regras de pausa, janelas de deploy e de manutenção suprimem o alerta durante eventos planejados; um cooldown mantém o mesmo alerta em silêncio após o envio, enquanto o ticket segue aberto; uma chave de dedup reaproveita o número do ticket existente; e quando a condição volta ao normal o ticket é resolvido automaticamente com um e-mail verde de RESOLVED. Toda avaliação fica registrada de qualquer forma, inclusive o cooldown que segurou um disparo.
O banco local é um store SQLCipher (AES) criptografado, ilegível sem a chave. Toda senha de sistema operacional, banco, serviço, administração e keystore é criptografada e nunca armazenada em texto claro. O acesso exige uma senha de aplicação obrigatória com hash Argon2, com 2FA TOTP opcional ou OTP por e-mail, e cada requisição é protegida por um token de máquina somado a uma sessão humana com tempo limitado. Chaves de host SSH e TLS são fixadas no primeiro uso. As credenciais são mascaradas no servidor antes de qualquer resposta sair da máquina, e o acesso a credenciais fica registrado.
Sim, e de forma explícita. As queries de monitoramento de banco são read-only por padrão; ações de escrita são controladas. A limpeza valida cada caminho, exige confirmação forte e é estruturalmente incapaz de remover o produto. Quando incidentes são encaminhados para uma ferramenta externa de resposta a incidentes, um canal de comando pode enviar instruções de volta, mas apenas depois que seis verificações independentes passarem: lista de remetentes autorizados, token HMAC, encadeamento da mensagem, uma regra pré-autorizadora, vinculação ao alvo e um ID de correlação de uso único. Ações reversíveis podem rodar sozinhas; start, stop e restart sempre aguardam aprovação humana. Cada mudança de configuração e cada escrita em banco deixa uma trilha read-only com o comando e a sua origem.
Sim. Observação e detecção não alteram nada no seu ambiente, e muitas equipes operam nesse nível indefinidamente. As capacidades de automação são configuradas deliberadamente, e as ações de real consequência continuam atrás de aprovação humana mesmo depois de habilitadas.
Relatórios que a sua equipe pode entregar para o negócio. O Health Report traz médias móveis de 7, 15 e 30 dias por servidor, com visão do período completo, status de limpeza e um advisor, exportado como uma página HTML autocontida. O Package Report acompanha projetos de build de package contra o cronograma e envia e-mail quando um deles trava. O Server History gera um retrato imprimível de qualquer escopo em um período. O Job Monitor mostra o histórico de UBE filtrado por job, versão, usuário, ambiente e fila, além do que está rodando agora com CPU ao vivo. O Warning Events registra achados não urgentes sem alertar ninguém. Exportações em HTML e Excel estão disponíveis nas telas que importam.
O AlwaysOn audita o próprio comportamento com treze verificações internas na família AON: SMTP desligado ou falhando silenciosamente, um grupo sem destinatários, uma regra mestre desativada, polling parado, métricas desatualizadas, licença próxima do vencimento, ou um auto-kill que ele não conseguiu confirmar. Esses achados aparecem apenas na tela Always Health, nunca por e-mail, porque uma pendência sobre e-mail não pode depender de e-mail para ser vista.
Sim. Um console HTTPS opcional em porta própria e separada, habilitado durante a instalação e desligado por padrão, enquanto o backend do desktop permanece em loopback no 127.0.0.1. As sessões web são multiusuário e independentes do desktop, então um login no navegador nunca derruba o do desktop. Valem as mesmas regras de login: senha de aplicação com Argon2 mais TOTP ou OTP por e-mail.
Comece por um diagnóstico AlwaysOn. Preencha o formulário nesta página, fale com a equipe NovaCon, pelo e-mail info@novaconweb.com ou pelo telefone +1 (646) 663-8667. Mapeamos a sua topologia JD Edwards, os componentes em escopo e as conexões necessárias, e mostramos o que o AlwaysOn revelaria no seu ambiente específico. O horário de atendimento é de segunda a sexta, das 9h às 18h (EST), e normalmente respondemos em até 24 horas úteis.
